Istio Gateway API Inference Extension
Istio에서 Gateway API Inference Extension이 어떻게 구현되어 동작하는지 분석한다. Istio는 1.27 Version부터 Gateway API Inference Extension을 지원하며, 분석한 Istio의 Version은 1.31이고 Gateway API Inference Extension의 Version은 v1.6이다.
1. Istio Gateway API Inference Extension
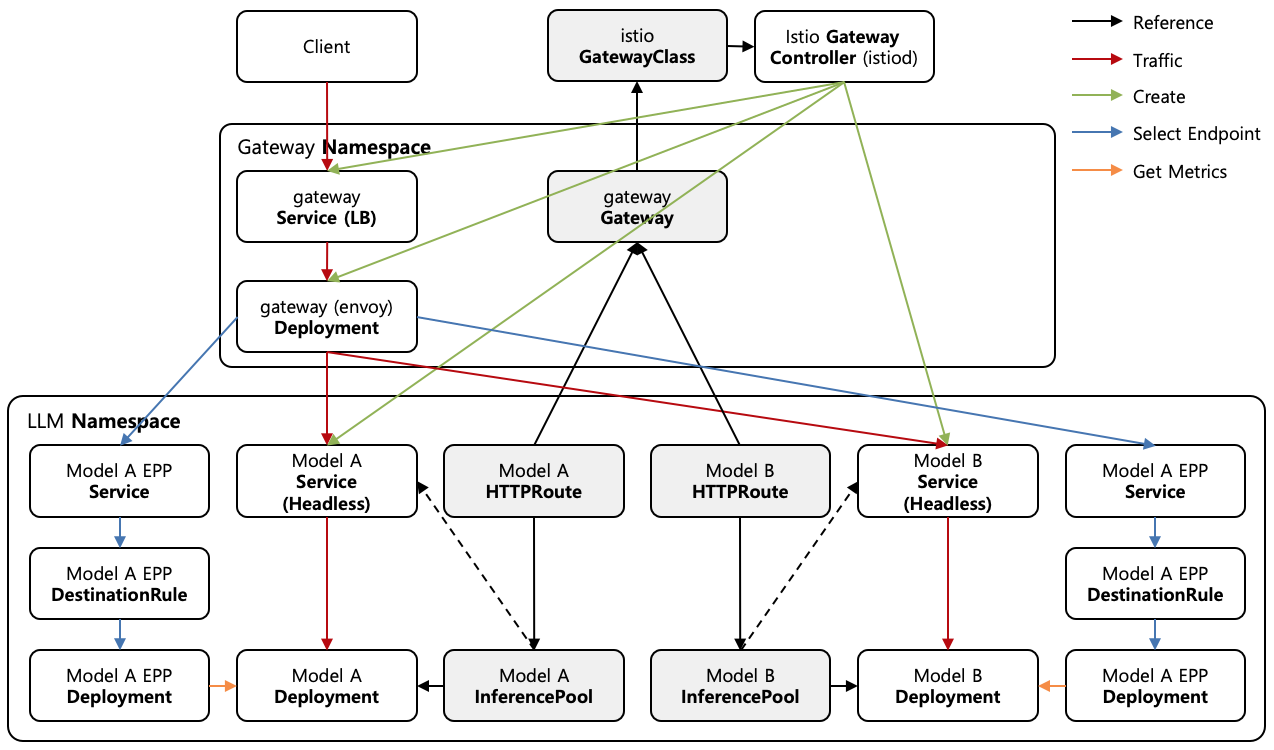
[Figure 1] Istio Inference Gateway 구성
Gateway API Inference Extension은 LLM Model Server로 전달되는 Inference Traffic을 제어하기 위한 Gateway API의 확장 표준이며, Istio는 Gateway API와 마찬가지로 Gateway API Inference Extension의 구현체 역할도 수행한다. Controller 역할은 별도의 Controller 설치 없이 istiod가 담당하며, istiod의 InferencePool Controller는 InferencePool, InferenceObjective 같은 Inference Resource를 Watch하고 있다가 InferencePool을 참조하는 HTTPRoute가 존재하면 InferencePool을 기존 Service Model로 변환하여 처리한다.
[Figure 1]은 Istio Inference Gateway의 구성을 나타내고 있다. InferencePool Controller가 변환한 설정은 Gateway API Controller, crdclient, Service Registry가 각각 Watch하는 Gateway API Resource, Istio CR, Kubernetes Service 설정과 함께 PushContext로 모이며, ConfigGenerator가 Envoy의 Listener, Route 설정으로 변환한 뒤에 DiscoveryServer가 xDS를 통해서 Gateway의 Envoy에 전달한다.
[Figure 1]의 llm Namespace처럼 하나의 Model은 Model Server의 Deployment, Model Server의 집합을 정의하는 InferencePool, Traffic을 InferencePool로 전달하는 HTTPRoute, 최적의 Model Server를 선택하는 전용 EPP (Endpoint Picker)의 조합으로 구성되며, Model마다 존재하는 EPP는 자신이 담당하는 Model Server의 Metric만 수집한다.
istiod는 Gateway의 Envoy Deployment와 Service뿐만 아니라, InferencePool에 대응하는 Shadow Service도 [Figure 1]의 model-a Headless Service처럼 함께 생성한다. Shadow Service는 Istio가 InferencePool이라는 새로운 개념을 직접 처리하는 대신 기존 Service와 동일한 방식으로 처리할 수 있도록, istiod가 InferencePool을 대신하여 생성하는 숨겨진 Headless Service이다. Shadow Service의 selector는 InferencePool의 selector로 설정되기 때문에, InferencePool이 선택한 Model Server Pod들은 일반 Service의 Pod처럼 Shadow Service의 Endpoint로 등록되어 관리된다.
Envoy에는 Inference를 위한 전용 기능이 존재하지 않기 때문에, Istio는 Envoy의 범용 기능인 External Processing (ext-proc) Filter와 Override Host Load Balancing Policy를 조합하여 Inference Traffic을 처리한다. [Figure 1]의 Select Endpoint 흐름과 같이 Client의 Inference 요청을 수신한 Gateway의 Envoy는 요청 정보를 EPP에게 전달하고, EPP는 Get Metrics 흐름을 통해서 수집한 Metric을 기반으로 최적의 Model Server Pod를 선택하여 Envoy에게 반환한다. Envoy는 EPP가 반환한 Model Server Pod로 요청을 전달한다.
1.1. Test 환경 구축
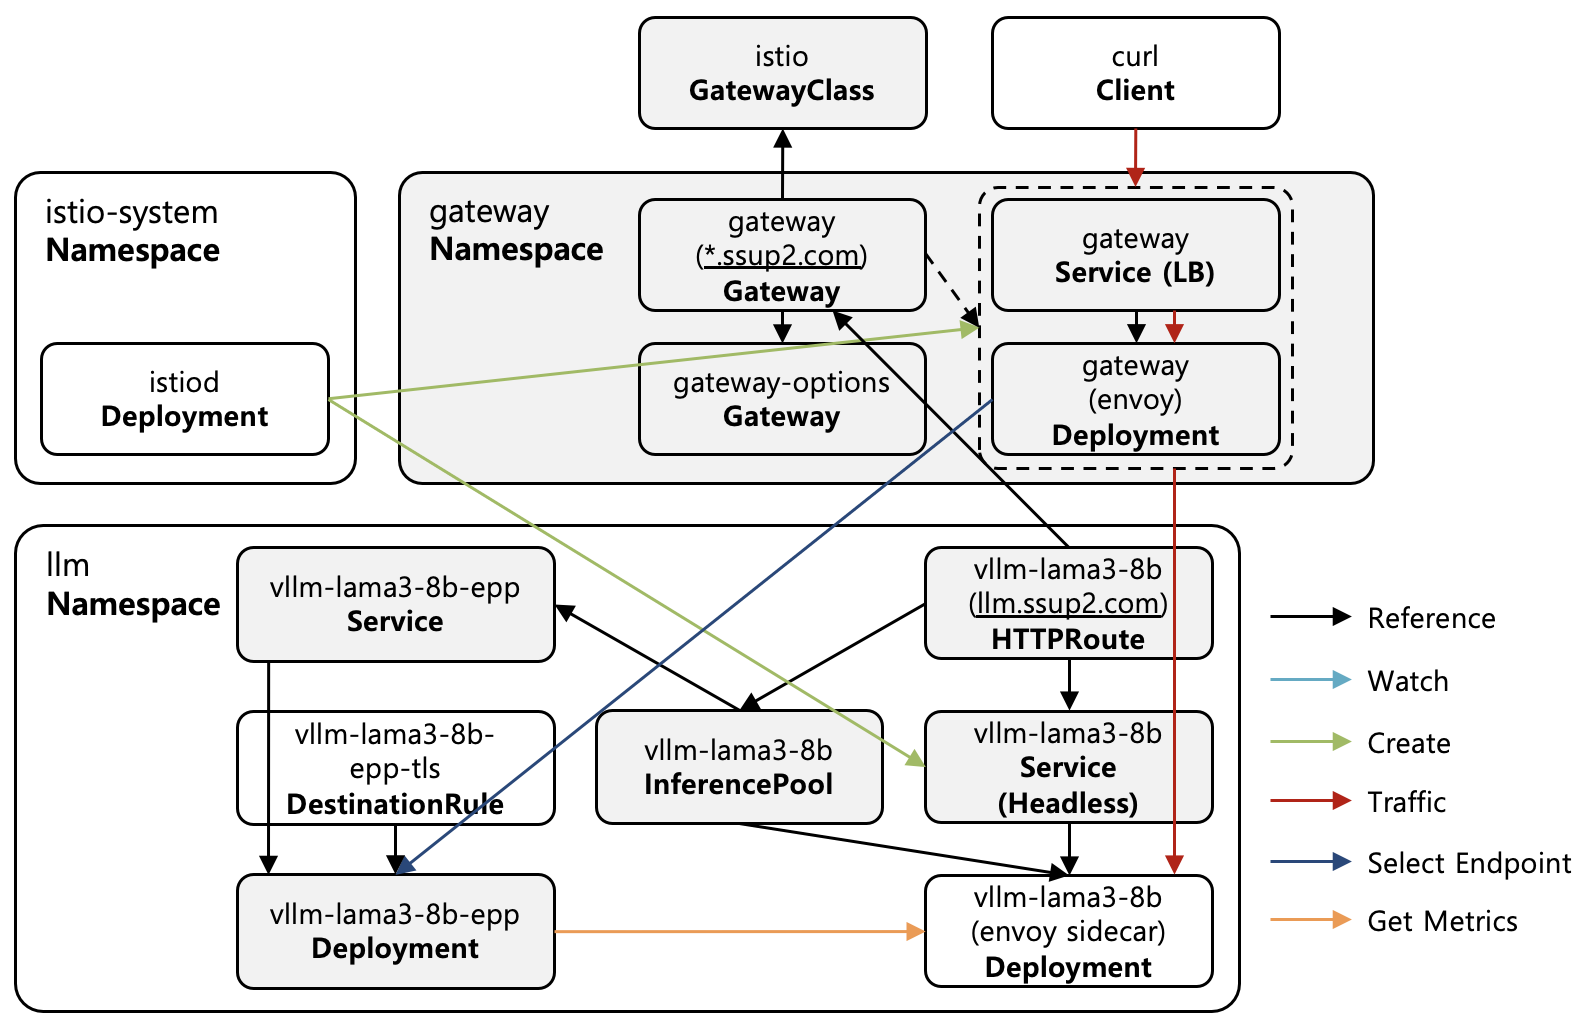
[Figure 2] Test 환경 구성
# Create kind cluster
$ kind create cluster --name istio-gateway-api

# Install gateway api CRDs (v1.6.0 standard channel)
$ kubectl apply -f https://github.com/kubernetes-sigs/gateway-api/releases/download/v1.6.0/standard-install.yaml

# Install gateway api inference extension CRDs (v1.6.2)
$ kubectl apply -f https://github.com/kubernetes-sigs/gateway-api-inference-extension/releases/download/v1.6.2/manifests.yaml

# Install istio with gateway api inference extension
$ istioctl install --set profile=minimal \
    --set values.pilot.env.SUPPORT_GATEWAY_API_INFERENCE_EXTENSION=true \
--set values.pilot.env.ENABLE_GATEWAY_API_INFERENCE_EXTENSION=true -yGateway API Inference Extension은 아직 Istio의 기본 기능으로 활성화되어 있지 않기 때문에, [Shell 1]과 같이 istiod의 환경 변수를 통해서 활성화해야 한다. 활성화 이후에는 별도의 Istio 전용 설정 없이 Gateway API Inference Extension의 InferencePool과 Gateway API의 Gateway, HTTPRoute Resource만으로 Inference Gateway를 구성할 수 있다. 이후 본문의 동작 확인은 [Shell 1]과 같이 kind Cluster에 Gateway API v1.6.0 CRD, Gateway API Inference Extension v1.6.2 CRD, Istio 1.31.0을 설치하여 수행한다.
| |
$ kubectl -n llm-namespace get pods -o wide
NAME                                   READY   STATUS    RESTARTS   AGE    IP
vllm-llama3-8b-56d558cb78-hnfzl        1/1     Running   0          21m    10.244.0.13
vllm-llama3-8b-56d558cb78-nw2p4        1/1     Running   0          21m    10.244.0.14
vllm-llama3-8b-56d558cb78-vw58t        1/1     Running   0          21m    10.244.0.15
vllm-llama3-8b-epp-5dc6dcfddc-bjcq7    1/1     Running   0          21m    10.244.0.16

$ kubectl -n llm-namespace get services
NAME                         TYPE        CLUSTER-IP     EXTERNAL-IP   PORT(S)     AGE
vllm-llama3-8b-epp           ClusterIP   10.96.249.74   <none>        9002/TCP    21m
vllm-llama3-8b-ip-22dc7de1 ClusterIP None <none> 54321/TCP 21mTest 환경의 Model Server는 [File 1]과 같이 GPU 없이 동작하는 vLLM Simulator 3개의 Pod로 구성하며, Lightweight EPP 기반의 vllm-llama3-8b-epp Deployment와 Service를 함께 생성한다. EPP는 TLS로 요청을 수신하기 때문에 Gateway와 EPP 사이의 TLS 연결을 위한 DestinationRule도 설정하며, EPP가 InferencePool과 Pod를 조회하기 위한 RBAC 구성은 [File 1]에서 생략하였다.
[File 1]을 적용하면 [Shell 2]와 같이 3개의 Model Server Pod와 EPP Pod, EPP Service가 생성된 것을 확인할 수 있다. Service 목록의 vllm-llama3-8b-ip-22dc7de1 Service는 이후 [File 2]의 InferencePool을 적용하면 istiod가 생성하는 Shadow Service이다.
| |
$ kubectl -n llm-namespace get inferencepool
NAME             AGE
vllm-llama3-8b   40m

$ kubectl -n llm-namespace get inferencepool vllm-llama3-8b -o jsonpath='{range .status.parents[0].conditions[*]}{.type}={.status} ({.reason}){"\n"}{end}'
Accepted=True (Accepted)
ResolvedRefs=True (ResolvedRefs)[File 2]는 Traffic을 수신하는 istio GatewayClass의 Gateway, Model Server Pod를 묶는 vllm-llama3-8b InferencePool, llm.ssup2.com Hostname의 Traffic을 InferencePool로 전달하는 HTTPRoute를 나타내고 있다. [Shell 3]은 [File 2] 적용 이후 생성된 InferencePool과 status를 나타내고 있다. status의 Accepted Condition을 통해서 InferencePool이 HTTPRoute를 통해서 Gateway에 정상적으로 연결된 것을 확인할 수 있고, ResolvedRefs Condition을 통해서 endpointPickerRef에 명시된 EPP 참조가 정상적으로 해석된 것을 확인할 수 있다. 이후 본문의 동작 확인은 이 상태의 Test 환경에서 수행한다.
1.2. InferencePool 변환
istiod는 InferencePool을 Istio의 기존 Service Model로 변환하여 처리한다. InferencePool이 생성되면 istiod는 InferencePool마다 [InferencePool 이름]-ip-[Hash].[Namespace].svc.cluster.local 형태의 이름을 갖는 Shadow Service를 Headless Service로 생성한다. Shadow Service의 selector와 Target Port는 InferencePool의 selector와 Target Port로 설정되기 때문에, selector에 부합하는 Model Server Pod들이 Shadow Service의 Endpoint로 등록된다. 따라서 Model Server Pod의 생성과 제거는 기존 Istio의 Service Discovery와 동일하게 EDS (Endpoint Discovery Service)를 통해서 Envoy에 반영된다.
Envoy에는 Shadow Service에 대응하는 outbound|54321||[Shadow Service 이름] 형태의 EDS Type Cluster가 생성된다. Cluster 이름의 54321은 Shadow Service에 이용되는 고정된 가상 Port이며, Traffic이 실제로 전달되는 Port는 Cluster의 Endpoint에 설정된 InferencePool의 Target Port이다. HTTPRoute의 backendRefs에 InferencePool이 명시되어 있으면, 해당 Route의 Cluster는 InferencePool의 Shadow Service Cluster로 설정된다. 이처럼 Istio는 InferencePool을 별도의 개념으로 처리하지 않고 기존 Service Model로 변환하기 때문에, Istio가 제공하는 mTLS와 Telemetry 기능도 InferencePool의 Model Server에 동일하게 적용할 수 있다.
$ istioctl proxy-config clusters gateway-istio-6cf9dd97dd-8lrn4 -n gateway-namespace | grep vllm
vllm-llama3-8b-epp.llm-namespace.svc.cluster.local             9002      -          outbound      EDS        vllm-llama3-8b-epp-tls.llm-namespace
vllm-llama3-8b-ip-22dc7de1.llm-namespace.svc.cluster.local     54321     -          outbound      EDS

$ istioctl proxy-config endpoints gateway-istio-6cf9dd97dd-8lrn4 -n gateway-namespace | grep vllm-llama3-8b-ip
10.244.0.13:8000        HEALTHY     OK     outbound|54321||vllm-llama3-8b-ip-22dc7de1.llm-namespace.svc.cluster.local
10.244.0.14:8000        HEALTHY     OK     outbound|54321||vllm-llama3-8b-ip-22dc7de1.llm-namespace.svc.cluster.local
10.244.0.15:8000        HEALTHY     OK     outbound|54321||vllm-llama3-8b-ip-22dc7de1.llm-namespace.svc.cluster.local
[Shell 4]는 vllm-llama3-8b InferencePool 생성 이후 Gateway Envoy의 Cluster와 Endpoint를 나타내고 있다. Model Server를 위한 Service는 별도로 생성하지 않았지만, [Shell 2]의 Service 목록에는 istiod가 생성한 vllm-llama3-8b-ip-22dc7de1 이름의 Shadow Service가 Headless Service로 존재하는 것을 확인할 수 있다. Envoy에는 Shadow Service에 대응하는 Cluster가 생성되어 있고, Cluster의 Endpoint에는 InferencePool의 selector로 선택된 3개의 Model Server Pod IP가 Target Port인 8000 Port와 함께 등록된 것을 확인할 수 있다.
1.3. 요청 처리 과정
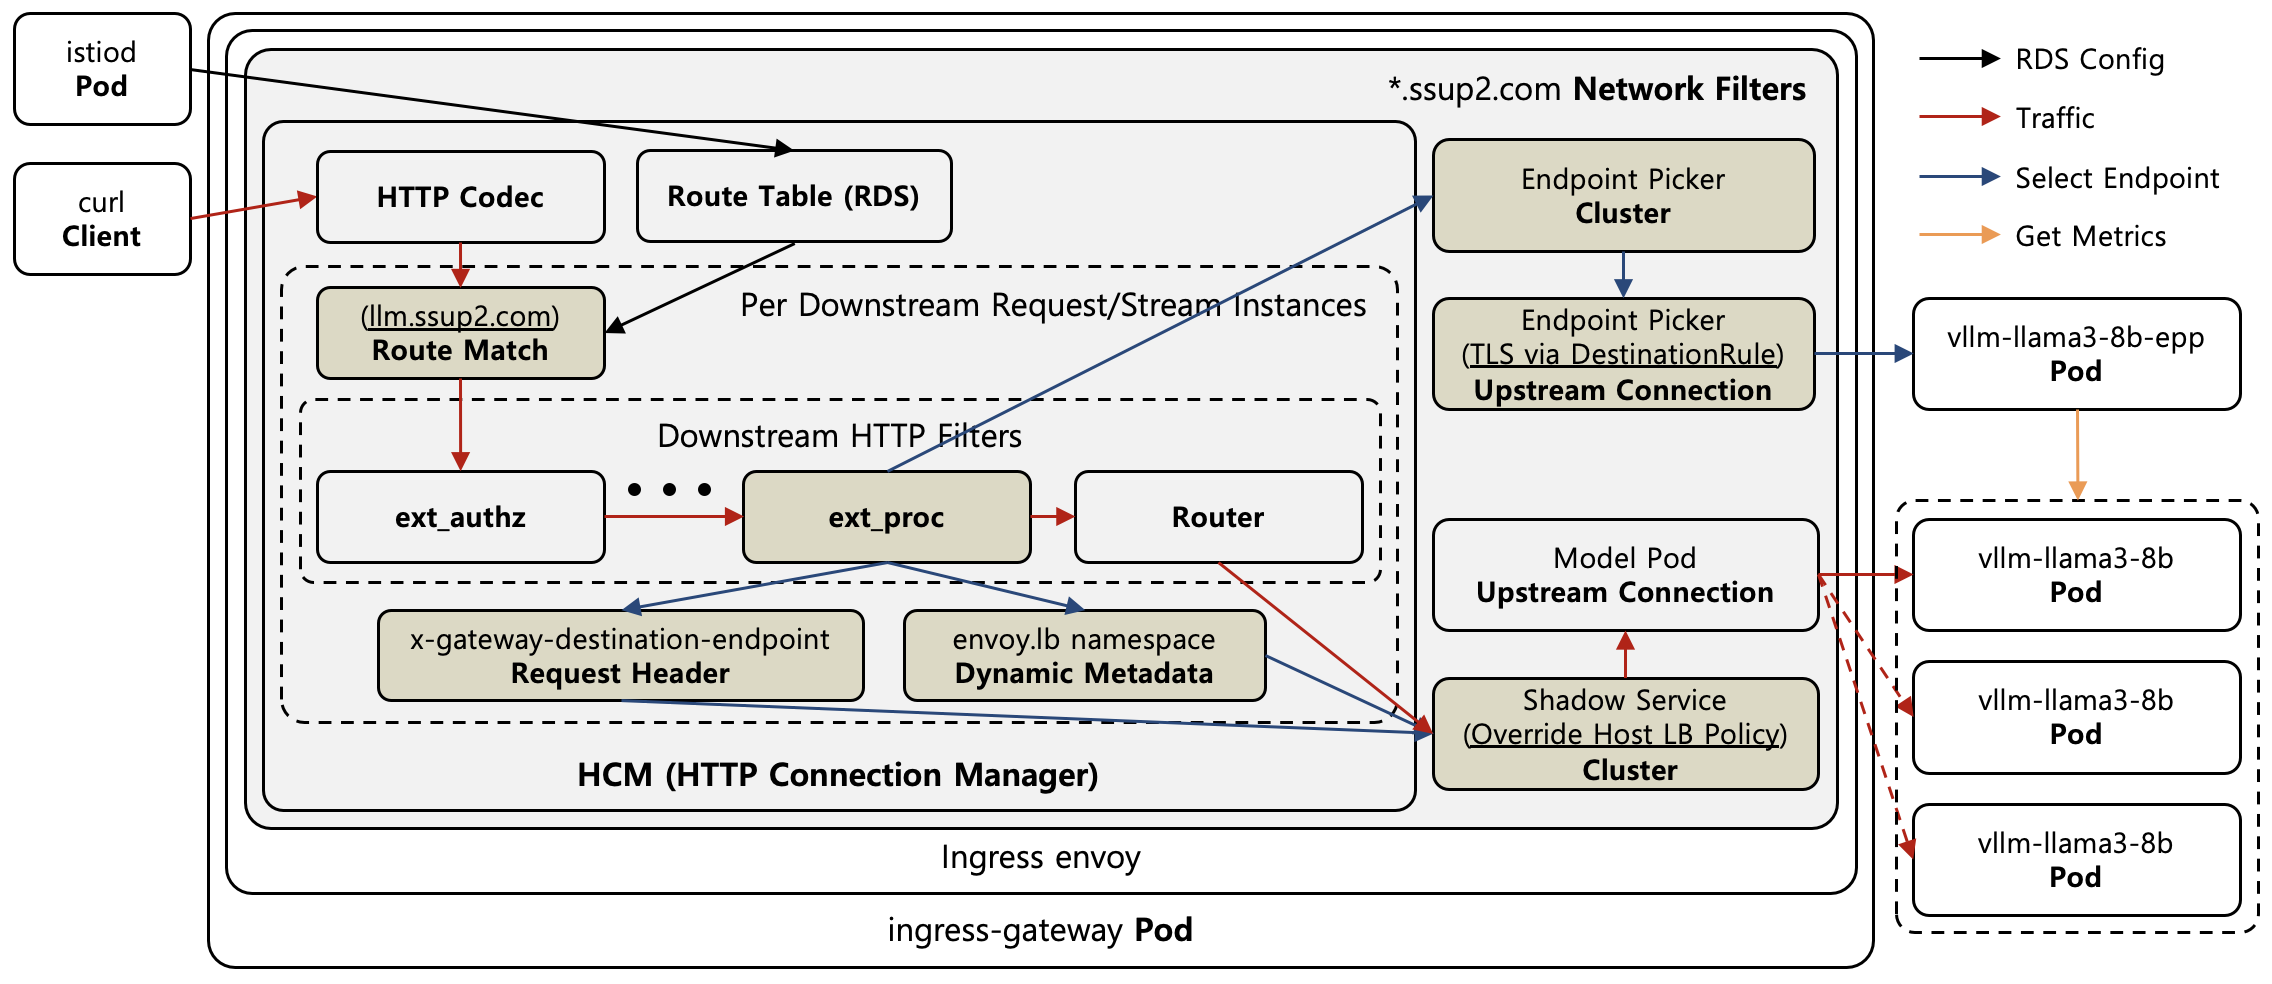
[Figure 3] Inference 요청 처리 과정
[Figure 3]은 Gateway Envoy의 Inference 요청 처리 과정을 나타내고 있다. istiod는 InferencePool을 참조하는 Route가 포함된 Route Table을 RDS를 통해서 Envoy에 전달하며, Client의 요청을 수신한 HTTP Connection Manager는 HTTP Codec으로 요청을 Decoding한 뒤에 Route Match를 통해서 llm.ssup2.com Hostname에 해당하는 Route를 선택한다.
Envoy의 ext-proc Filter는 요청과 응답의 Header, Body를 외부 gRPC Server에 전달하여 외부 Server가 Traffic을 검사하고 수정할 수 있도록 하는 HTTP Filter이며, Inference Extension에서는 EPP가 ext-proc 요청을 수신하는 외부 gRPC Server 역할을 수행한다. [Figure 3]과 같이 ext-proc Filter는 Downstream HTTP Filter Chain의 중간에 위치하며, EPP와의 연결은 별도의 Endpoint Picker Cluster를 통해서 수행되고 [File 1]의 DestinationRule에 의해서 TLS가 적용된다.
Override Host Load Balancing Policy는 Load Balancing 알고리즘으로 Endpoint를 선택하지 않고, 요청의 특정 Header나 요청에 설정된 Envoy Metadata에서 Endpoint 주소를 읽어 해당 Endpoint로 Traffic을 전달하는 Load Balancing 정책이며, [Figure 3]과 같이 Shadow Service Cluster에 설정된다. Envoy는 두 기능을 통해서 EPP가 선택한 Model Server Pod로 Inference 요청을 전달한다.
$ istioctl proxy-config routes gateway-istio-6cf9dd97dd-8lrn4 -n gateway-namespace --name http.80 -o json
...
        "routes": [
            {
                "name": "llm-namespace.llm-route.0",
                ...
                "route": {
                    "cluster": "outbound|54321||vllm-llama3-8b-ip-22dc7de1.llm-namespace.svc.cluster.local",
                    ...
                },
                "typedPerFilterConfig": {
                    "envoy.filters.http.ext_proc": {
                        "@type": "type.googleapis.com/envoy.extensions.filters.http.ext_proc.v3.ExtProcPerRoute",
                        "overrides": {
                            "processingMode": {
                                "requestHeaderMode": "SEND",
                                "responseHeaderMode": "SEND",
                                "requestBodyMode": "FULL_DUPLEX_STREAMED",
                                "responseBodyMode": "FULL_DUPLEX_STREAMED",
                                ...
                            },
                            "grpcService": {
                                "envoyGrpc": {
                                    "clusterName": "outbound|9002||vllm-llama3-8b-epp.llm-namespace.svc.cluster.local"
                                }
                            },
                            "failureModeAllow": true
                        }
                    }
                }
            }
        ]
...
[Shell 5]는 InferencePool을 참조하는 Route에 설정된 ext-proc Filter의 실제 설정을 나타내고 있다. Route의 Cluster는 InferencePool의 Shadow Service Cluster로 설정되어 있으며, ext-proc Filter의 grpcService에는 EPP의 Cluster가 명시되어 있다.
Gateway의 Envoy가 요청을 수신하면 HTTPRoute의 matches 조건에 따라서 Route Match가 InferencePool의 Route를 선택하고, Route에 설정된 ext-proc Filter는 요청의 Header와 Body를 EPP에게 gRPC로 전달한다. ext-proc Filter는 InferencePool을 참조하는 Route에만 설정되기 때문에, 동일한 Gateway에서 일반 Service로 전달되는 요청은 EPP를 경유하지 않는다. Route 설정에는 특정 Pod를 지정하는 부분이 존재하지 않으며, Route는 요청을 EPP에게 전달하는 것까지만 담당하고 EPP가 선택한 Pod로 요청을 전달하는 동작은 Shadow Service Cluster의 Load Balancing 설정이 담당한다.
$ curl -s -i -H "Host: llm.ssup2.com" http://127.0.0.1:8080/v1/completions \
    -d '{"model": "reviews-1", "prompt": "What do reviewers think about The Comedy of Errors?", "max_tokens": 100, "temperature": 0}'
HTTP/1.1 200 OK
...
server: istio-envoy
x-inference-pod: vllm-llama3-8b-56d558cb78-hnfzl
x-inference-port: 8000
...
{"id":"cmpl-02401d40-5ed9-5702-9895-6e8cf93783bb","created":1789907157,"model":"reviews-1","usage":{"prompt_tokens":10,"completion_tokens":36,"total_tokens":46},"object":"text_completion",...}
[Shell 6]은 port-forward를 통해서 Gateway로 Inference 요청을 전송한 결과를 나타내고 있다. 요청은 vLLM Simulator에 의해서 정상적으로 처리되며, 응답의 x-inference-pod Header를 통해서 요청을 처리한 Model Server Pod를 확인할 수 있다.
# Port-forward to a model server pod
$ kubectl -n llm-namespace port-forward pod/vllm-llama3-8b-56d558cb78-hnfzl 8000:8000 &

$ curl -s http://127.0.0.1:8000/metrics
# HELP vllm:cache_config_info Information of the LLMEngine CacheConfig.
# TYPE vllm:cache_config_info gauge
vllm:cache_config_info{block_size="16",num_gpu_blocks="1024"} 1
# HELP vllm:kv_cache_usage_perc Prometheus metric for the fraction of KV-cache blocks currently in use (from 0 to 1).
# TYPE vllm:kv_cache_usage_perc gauge
vllm:kv_cache_usage_perc{model_name="meta-llama/Llama-3.1-8B-Instruct"} 0
# HELP vllm:lora_requests_info Running stats on lora requests.
# TYPE vllm:lora_requests_info gauge
vllm:lora_requests_info{max_lora="2",running_lora_adapters="",waiting_lora_adapters=""} 1.790053209e+09
# HELP vllm:num_requests_running Number of requests currently running on GPU.
# TYPE vllm:num_requests_running gauge
vllm:num_requests_running{model_name="meta-llama/Llama-3.1-8B-Instruct"} 0
# HELP vllm:num_requests_waiting Prometheus metric for the number of queued requests.
# TYPE vllm:num_requests_waiting gauge
vllm:num_requests_waiting{model_name="meta-llama/Llama-3.1-8B-Instruct"} 0
[Shell 7]은 Model Server Pod의 /metrics Endpoint를 조회한 결과를 나타내고 있다. EPP는 각 Model Server의 Metric을 주기적으로 수집하며, Queue에 대기 중인 요청의 개수를 나타내는 vllm:num_requests_waiting, KV Cache 사용률을 나타내는 vllm:kv_cache_usage_perc, 적재된 LoRA Adapter 목록을 나타내는 vllm:lora_requests_info를 기반으로 최적의 Model Server Pod를 선택한다. Model Server가 노출해야 하는 Metric의 규격은 Model Server Protocol로 표준화되어 있기 때문에, vLLM이 아닌 다른 Model Serving Platform도 동일한 방식으로 이용할 수 있다.
EPP는 선택한 Pod의 주소를 ext-proc 응답에 실어서 Envoy에게 반환하며, 주소는 EPP Protocol이 표준으로 정의한 x-gateway-destination-endpoint 이름으로 [Figure 3]과 같이 요청에 추가되는 Header와 응답의 dynamic_metadata 필드 두 곳에 동일하게 설정된다. dynamic_metadata는 외부 Server가 Envoy 내부에 저장할 값을 전달할 수 있도록 ext-proc 응답 Message에 정의되어 있는 필드이다. Envoy의 ext-proc Filter는 응답의 dynamic_metadata 필드에서 envoy.lb Namespace의 값을 꺼내서 처리 중인 요청의 Metadata로 저장한다. Metadata는 Header와 다르게 요청 메시지에 포함되어 전송되는 값이 아니라, Envoy가 요청 하나를 처리하는 동안만 내부적으로 유지하는 요청별 상태이다.
Envoy의 Cluster에는 Override Host Load Balancing Policy가 설정되어 있기 때문에, Envoy는 일반적인 Load Balancing 알고리즘 대신 Metadata에 명시된 Pod로 요청을 전달한다. Metadata가 존재하지 않는 경우에는 Fallback으로 설정된 Load Balancing 알고리즘을 이용한다.
$ istioctl proxy-config clusters gateway-istio-6cf9dd97dd-8lrn4 -n gateway-namespace \
    --fqdn "vllm-llama3-8b-ip-22dc7de1.llm-namespace.svc.cluster.local" -o json
...
        "loadBalancingPolicy": {
            "policies": [
                {
                    "typedExtensionConfig": {
                        "name": "envoy.load_balancing_policies.override_host",
                        "typedConfig": {
                            "@type": "type.googleapis.com/envoy.extensions.load_balancing_policies.override_host.v3.OverrideHost",
                            "overrideHostSources": [
                                {
                                    "metadata": {
                                        "key": "envoy.lb",
                                        "path": [
                                            {
                                                "key": "x-gateway-destination-endpoint"
                                            }
                                        ]
                                    }
                                }
                            ],
                            ...
                            "fallbackPolicy": {
                                "policies": [
                                    {
                                        "typedExtensionConfig": {
                                            "name": "envoy.load_balancing_policies.round_robin",
                                            ...
[Shell 8]은 Shadow Service Cluster에 설정된 Override Host Load Balancing Policy를 나타내고 있다. EPP가 반환한 Endpoint 주소는 Envoy의 envoy.lb Metadata에 x-gateway-destination-endpoint Key로 저장되어 참조되며, Fallback Load Balancing 알고리즘은 Round Robin으로 설정되어 있는 것을 확인할 수 있다. Listener의 ext-proc Filter에는 metadata_options의 receiving_namespaces에 envoy.lb Namespace가 설정되어 있기 때문에, EPP가 ext-proc 응답에 설정한 Metadata는 Envoy에 수신되어 Override Host Load Balancing Policy가 참조할 수 있는 상태로 저장된다.
InferencePool의 failureMode는 ext-proc Filter의 failure_mode_allow 설정으로 변환된다. FailOpen으로 설정되어 있으면 failure_mode_allow는 true로 설정되어 EPP 장애시에도 요청은 Fallback Load Balancing을 통해서 전달되며, FailClose로 설정되어 있으면 EPP 장애시 요청은 실패한다. Test 환경의 InferencePool은 FailOpen으로 설정되어 있기 때문에, [Shell 5]에서 failureModeAllow가 true로 변환된 것을 확인할 수 있다.
2. 참조
- Istio Gateway API Inference Extension 지원 : https://istio.io/latest/blog/2025/inference-extension-support/
- Istio Gateway API Inference Extension Task : https://istio.io/latest/docs/tasks/traffic-management/ingress/gateway-api-inference-extension/
- Gateway API Inference Extension : https://gateway-api-inference-extension.sigs.k8s.io/
- Gateway API Inference Extension Deep Dive : https://www.cncf.io/blog/2025/04/21/deep-dive-into-the-gateway-api-inference-extension/
- Endpoint Picker Protocol : https://github.com/kubernetes-sigs/gateway-api-inference-extension/tree/main/docs/proposals/004-endpoint-picker-protocol
- Envoy Override Host Load Balancing Policy : https://github.com/istio/istio/issues/56230
- Istio InferencePool 변환 : https://github.com/istio/istio/issues/57638