Kubernetes HAMi
1. Kubernetes HAMi
HAMi (Heterogeneous AI Computing Virtualization Middleware)는 Kubernetes 환경에서 GPU, NPU 같은 AI Accelerator를 가상화하여 하나의 Accelerator를 다수의 Pod이 공유할 수 있도록 하는 Middleware이다. HAMi는 Kubernetes의 Device Plugin 방식 위에서 Memory 크기 제한과 연산 Core 사용률 제한을 제공하여 하나의 Accelerator를 다수의 Pod에 공유 할당할 수 있도록 만든다.
| 단계 | Device Plugin 방식의 한계 | HAMi의 해결 방식 |
|---|---|---|
| Resource 요청 | Accelerator를 정수 개수의 Resource로만 다루어 Memory 크기나 Core 사용률을 요청할 수 없다. | Accelerator 개수를 부풀려 등록하고, Memory 크기와 Core 사용률은 별도의 Resource로 요청한다. |
| Node 선택 | kube-scheduler는 Node별 Accelerator 개수만 알고, 개별 Accelerator에 남은 Memory 크기와 Core 사용률은 알 수 없다. | HAMi Device Plugin이 Accelerator의 상세 정보를 Node Annotation에 기록하고, HAMi Scheduler가 이를 참조한다. |
| Accelerator 선택 | 어떤 Accelerator를 할당할지는 Pod가 Node에 Bind된 이후 kubelet이 Device ID 기준으로 결정하기 때문에, Pod가 요청한 Memory 크기와 Core 사용률을 만족하는 Accelerator가 선택된다는 보장이 없다. | HAMi Scheduler가 Node와 Accelerator를 함께 선택하고, 선택 결과를 Pod Annotation으로 HAMi Device Plugin에 전달한다. |
| Accelerator 사용 | Accelerator를 나눠 쓰더라도 각 Pod의 사용량을 제한하는 수단이 없다. | 격리 계층이 Memory 크기와 Core 사용률 제한을 강제한다. |
다만 Device Plugin 규격은 Device의 ID와 Health 상태 같은 제한된 정보만 주고받도록 정해져 있어 직접 확장할 수 없기 때문에, HAMi는 Device Plugin 규격은 그대로 따르면서 그 제약을 우회하는 방식을 이용한다. [Table 1]은 Kubernetes의 Device Plugin 방식으로 Accelerator를 공유할 때의 한계와 HAMi의 해결 방식을 나타내고 있다. HAMi는 HAMi Scheduler가 Accelerator 선택까지 수행하고 그 결과를 Annotation으로 HAMi Device Plugin에 전달하는 구조와 격리 계층을 통해서 이 한계를 해결한다.
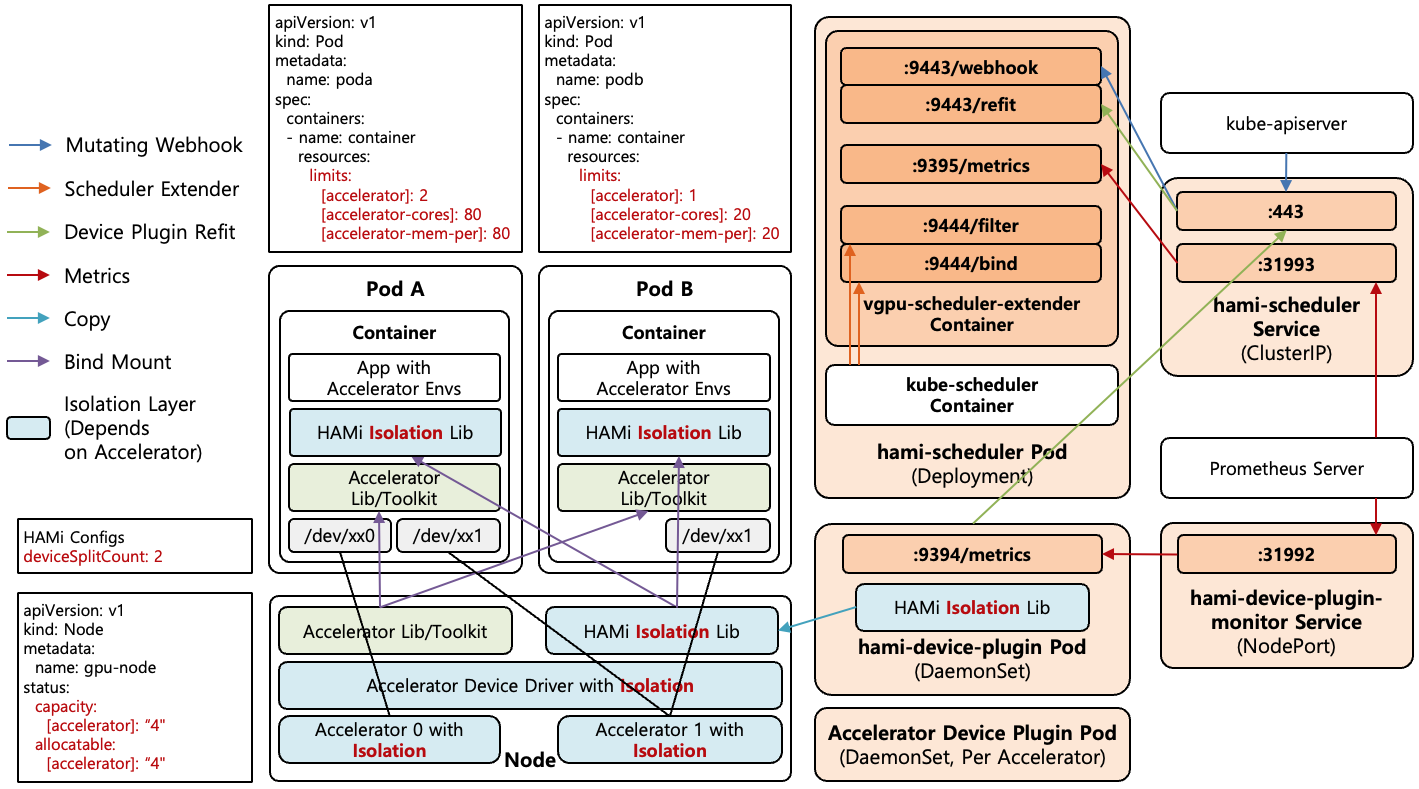
[Figure 1] HAMi Architecture
[Figure 1]은 HAMi의 Architecture를 나타내고 있다. HAMi의 구성 요소와 Monitoring은 다음과 같다.
- HAMi Scheduler :
hami-schedulerDeployment를 통해서 동작하며, 하나의 Pod 안에서 kube-scheduler Container와 Scheduler Extender Container가 함께 동작한다. [Figure 1]의 Scheduler Extender 경로와 같이 kube-scheduler는 같은 Pod 안의 Scheduler Extender를 Loopback (9444Port) 으로 호출한다. Accelerator를 요청하는 Pod의 Scheduler를 HAMi Scheduler로 변경하는 Mutating Webhook도 Scheduler Extender가 함께 제공하며, [Figure 1]의 Mutating Webhook 경로와 같이 kube-apiserver가hami-schedulerService를 통해서 이를 호출한다. 모든 종류의 Accelerator가 하나의 HAMi Scheduler를 공유하며, Accelerator별 Scheduling 동작은 HAMi Scheduler 내부의 Accelerator별 Package로 구현되어 있다. - HAMi Device Plugin :
hami-device-pluginDaemonSet을 통해서 Accelerator가 존재하는 Node에서 동작하며, Accelerator를 kubelet에 등록하고, Accelerator의 Health 상태를 확인하며, Accelerator를 Container에 할당하는 역할을 수행한다. NUMA 정렬 때문에 HAMi Scheduler가 선택한 Accelerator를 할당할 수 없으면, [Figure 1]의 Device Plugin Refit 경로와 같이 HAMi Scheduler에게 Accelerator를 다시 선택하도록 요청한다. - 격리 계층 : 공유 할당된 Accelerator가 제한을 초과하여 사용되지 않도록 강제하는 계층이다. HAMi Scheduler가 선택한 Device와 제한 값을 Pod Annotation에 기록하고 HAMi Device Plugin이 이를 참조하여 할당하는 방식을 HAMi Protocol이라고 하며, 격리는 다음의 세 가지 수준으로 분류된다. 계층이 Hardware에 가까울수록 격리는 강해지지만 분할의 유연성은 줄어든다.
- Library 수준 격리 : Container에 주입된 격리 Library가 User 공간에서 Accelerator API 호출을 가로채서 Memory 할당과 Core 사용을 제한한다. 제한이 API 호출 시점에 이루어지기 때문에 Memory 크기와 Core 사용률을 임의의 값으로 지정할 수 있다. 격리 Library는 HAMi Device Plugin이 시작될 때 [Figure 1]의 Copy를 통해서 Node에 설치되고, Pod에 Accelerator가 할당되면 [Figure 1]의 Bind Mount를 통해서 Container에 전달된다.
- Driver 수준 격리 : 하드웨어 자체는 공유된 상태에서 Accelerator Driver가 각 Pod의 Memory 할당량과 Core 사용률을 추적하고 강제한다. 제한을 Application이 아니라 Driver가 수행하기 때문에 별도의 Library 주입이 필요하지 않고, 하나의 물리 Accelerator 위에 할당량이 설정된 다수의 Instance를 올릴 수 있다.
- Hardware 수준 격리 : 하드웨어 자체가 물리적으로 분할되어 각 Partition이 독립된 Memory와 Core를 갖는 가상 Accelerator가 생성된다. 분할 가능한 구성은 제조사가 Chip마다 미리 정의한 Template (고정된 Memory와 Core 조합) 집합으로 한정되며, Pod에는 이 Template 중 하나가 할당된다. 격리가 가장 확실한 대신 Template보다 세밀한 분할은 불가능하다.
- Monitoring : [Figure 1]의 Metrics 경로와 같이 HAMi Scheduler는
9395Port에서 Accelerator별, Pod별 할당 내역을, HAMi Device Plugin의vgpu-monitorContainer는9394Port에서 GPU 상태와 Container별 실제 GPU 사용량을 Prometheus Metric으로 제공한다.vgpu-monitorContainer는 NVIDIA GPU용 HAMi Device Plugin에만 포함되기 때문에 실제 사용량 Metric은 NVIDIA GPU에서만 제공된다.
[Figure 1]의 Node에는 물리 Accelerator가 2개 존재하며, HAMi 설정의 분할 개수 (deviceSplitCount) 가 2로 지정되어 있기 때문에 Node의 Allocatable/Capacity에는 4개의 Accelerator가 등록된다. 즉 물리 Accelerator 하나를 최대 2개의 Container가 나눠 쓸 수 있다. Pod A는 Accelerator 2개를 Core 사용률과 Memory 80%로, Pod B는 Accelerator 1개를 Core 사용률과 Memory 20%로 요청하여, Accelerator 1은 Pod A와 Pod B가 함께 사용한다.
| Accelerator | Accelerator Resource 이름 | Memory / Core 제한 | 격리 계층 | Device Plugin |
|---|---|---|---|---|
| NVIDIA GPU | nvidia.com/gpu, nvidia.com/gpumem, nvidia.com/gpucores | O / O | Library, Hardware | HAMi 포함 |
| Huawei Ascend NPU | huawei.com/Ascend910B3, huawei.com/Ascend910B3-memory | O / O | Hardware | HAMi 별도 |
| Kunlunxin XPU | kunlunxin.com/vxpu, kunlunxin.com/vxpu-memory | O / X | Hardware | HAMi 별도 |
| AMD GPU | amd.com/gpu, amd.com/gpumem, amd.com/gpucores | O / O | Library | HAMi 별도 |
[Table 2]는 HAMi Protocol을 따르는 Device Plugin이 제공되는 주요 Accelerator와 Accelerator Resource 이름, 격리 계층, Device Plugin 패키징을 나타내고 있다. Accelerator Resource 이름은 Pod가 resources에 Accelerator를 요청할 때 이용하는 Kubernetes Extended Resource의 이름이며, 각 Accelerator는 개수를 요청하는 Resource와 함께 Memory 크기, Core 사용률을 요청하는 Resource를 제공한다. 이 중에서 개수를 요청하는 Resource (예: nvidia.com/gpu) 는 HAMi Device Plugin이 kubelet에 등록하기 때문에 Node의 Allocatable에 나타나지만, Memory 크기와 Core 사용률을 요청하는 Resource는 Node에 등록되지 않고 HAMi Scheduler만 인식하여 Scheduling에 활용한다.
HAMi Scheduler는 hami-scheduler-device ConfigMap에 정의된 Accelerator별 Resource 이름을 기준으로 동작한다. Mutating Webhook은 이 이름으로 Accelerator를 요청하는 Pod를 판별하고, Scheduler Extender는 Pod가 요청한 개수, Memory 크기, Core 사용률을 읽어 Accelerator를 선택한다. Device Plugin은 HAMi 포함 (HAMi Helm Chart 기본 포함)과 HAMi 별도 (Project-HAMi 저장소의 별도 Chart, Manifest) 두 가지 방식으로 배포되며, NVIDIA GPU 외에는 HAMi 설치와 별개로 각 Device Plugin을 설치해야 한다.
| Accelerator | Accelerator Resource 이름 | Memory / Core 제한 | 격리 계층 |
|---|---|---|---|
| Cambricon MLU | cambricon.com/vmlu, cambricon.com/mlu.smlu.vmemory, cambricon.com/mlu.smlu.vcore | O / O | Driver |
| Hygon HCU | hygon.com/hcunum, hygon.com/hcumem, hygon.com/hcucores | O / O | Driver |
| Iluvatar GPU | iluvatar.ai/MR-V100-vgpu, iluvatar.ai/MR-V100.vMem, iluvatar.ai/MR-V100.vCore | O / O | Library |
| Moore Threads GPU | mthreads.com/vgpu, mthreads.com/sgpu-memory, mthreads.com/sgpu-core | O / O | Driver |
| MetaX GPU | metax-tech.com/sgpu, metax-tech.com/vmemory, metax-tech.com/vcore | O / O | Driver |
| AWS Neuron | aws.amazon.com/neuron, aws.amazon.com/neuroncore | X / O | Hardware |
[Table 3]은 HAMi가 제조사 제공 Device Plugin을 그대로 이용하여 지원하는 주요 Accelerator를 나타내고 있다. HAMi 2.11.0 기준으로 hami-scheduler-device ConfigMap에는 [Table 2], [Table 3]의 Accelerator를 포함하여 총 13종의 Accelerator 설정이 정의되어 있다. [Table 3]의 Resource 이름은 모두 벤더 Device Plugin이 kubelet에 등록하는 자체 이름이며, HAMi는 hami-scheduler-device ConfigMap에 이 이름들을 등록해 두어 Mutating Webhook과 Scheduler Extender가 Pod의 요청을 인식하도록만 한다.
제조사 Device Plugin을 쓸 때는 Device 선택과 격리 적용을 모두 벤더 Plugin이 담당하기 때문에, HAMi는 Scheduling에만 관여한다. 격리 계층은 Accelerator Driver가 담당하는 Driver 수준이 다수이며, 일부는 벤더 Library 주입 (Library 수준) 이나 Hardware 분할 (Hardware 수준) 도 함께 쓴다. 이 경우 HAMi가 제공하는 가치는 Pod Annotation 기반의 Scheduling 정책 지정과 여러 벤더를 하나의 Scheduler로 통합 운영하는 수준에 그치며, HAMi의 핵심 가치는 HAMi Protocol을 이용할 때 나타난다.
$ kubectl -n kube-system get configmap hami-scheduler-device -o jsonpath='{.data.device-config\.yaml}'
nvidia:
  resourceCountName: nvidia.com/gpu
  resourceMemoryName: nvidia.com/gpumem
  resourceMemoryPercentageName: nvidia.com/gpumem-percentage
  resourceCoreName: nvidia.com/gpucores
  resourcePriorityName: nvidia.com/priority
  ...
  deviceSplitCount: 10
  deviceMemoryScaling: 1
  deviceCoreScaling: 1
  ...
cambricon:
  resourceCountName: cambricon.com/vmlu
  resourceMemoryName: cambricon.com/mlu.smlu.vmemory
  resourceCoreName: cambricon.com/mlu.smlu.vcore
hygon:
  resourceCountName: hygon.com/hcunum
  resourceMemoryName: hygon.com/hcumem
  resourceCoreName: hygon.com/hcucores
  memoryFactor: 1
...
[Shell 1]은 hami-scheduler-device ConfigMap에 정의된 Accelerator별 Resource 이름 설정을 나타내고 있다. 각 Accelerator Section (nvidia, cambricon, hygon 등) 아래에 개수, Memory, Core Resource 이름이 정의되며, HAMi Device Plugin이 kubelet에 등록할 Resource 이름과 Scheduler Extender가 Pod의 요청에서 인식할 Resource 이름이 이 설정으로 통일된다. 각 Section에는 Resource 이름 외에도 물리 Accelerator 하나의 분할 개수 같은 Accelerator별 설정이 함께 담기며, 설정 항목은 Accelerator마다 다르다.
1.1. Accelerator 등록
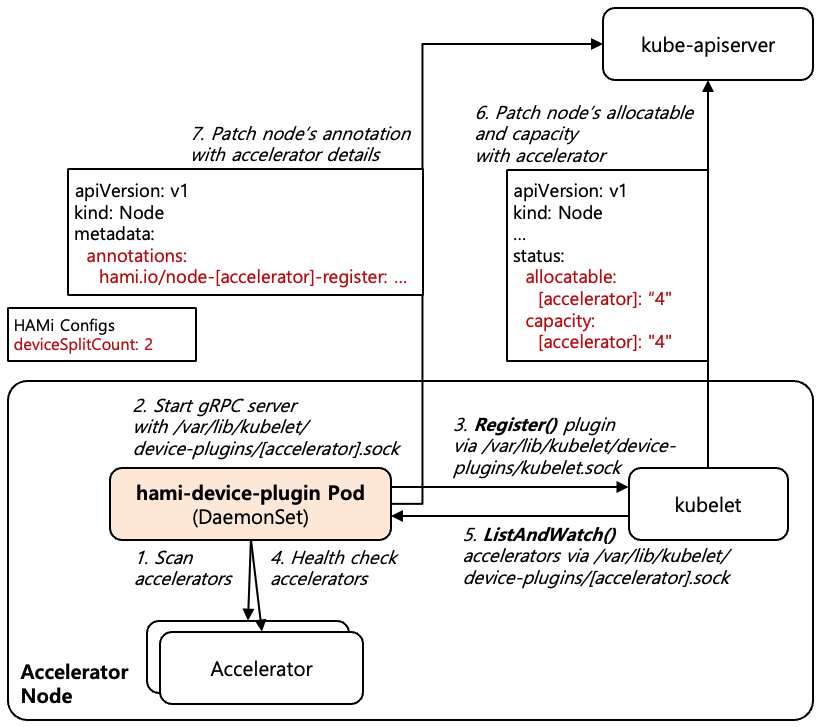
[Figure 2] Accelerator Registration Process
Accelerator 등록은 HAMi Device Plugin이 수행하며, Node에 존재하는 물리 Accelerator를 분할 개수만큼 부풀려서 Kubernetes에 등록한다. [Figure 2]는 Accelerator 등록 과정을 나타내고 있다.
- HAMi Device Plugin이
hami-device-pluginDaemonSet을 통해서 Accelerator Node에서 동작을 시작하며, 분할 개수 (deviceSplitCount) 같은 Accelerator별 설정을 읽고 Node의 Accelerator를 탐색하여 UUID, Memory 크기, Core 개수, Type 정보를 파악한다. - HAMi Device Plugin은
/var/lib/kubelet/device-plugins/Directory에 자신의 Unix Domain Socket을 생성하고 gRPC Server를 시작한다. Socket 파일 이름은 Device Plugin마다 다르며, NVIDIA GPU는nvidia-gpu.sock을 이용한다. - HAMi Device Plugin은 kubelet의 Unix Domain Socket (
/var/lib/kubelet/device-plugins/kubelet.sock) 을 통해서Register()gRPC 요청을 전송하여 Plugin 자신을 kubelet에 등록한다. 요청에는 Resource 이름과 2단계에서 생성한 Socket 파일 이름이 포함된다. - HAMi Device Plugin은 등록 이후 Accelerator의 Health 상태 확인을 시작한다. 장애를 감지하면 해당 물리 Accelerator에서 부풀려진 항목을
Unhealthy상태로 kubelet에 다시 전달하고, Node Annotation의health값도 갱신하여 해당 Accelerator가 할당 후보에서 제외되도록 한다. - kubelet은 전달받은 Socket을 통해서 HAMi Device Plugin에게
ListAndWatch()gRPC 요청을 전송하여 Accelerator 목록을 수신한다. 이때 HAMi Device Plugin은 물리 Accelerator의 개수를 분할 개수 설정 (deviceSplitCount) 의 배수만큼 부풀려서 전달한다. 예를 들어 물리 Accelerator가 2개 존재하고 분할 개수가 2로 설정되어 있으면 4개의 Accelerator가 전달되며, 하나의 물리 Accelerator를 최대 2개의 Container에 할당할 수 있다는 의미가 된다. - kubelet은 전달받은 Accelerator 개수를 kube-apiserver를 통해서 Node의 Allocatable/Capacity에 반영한다.
- HAMi Device Plugin은 Device Plugin 규격과 별도로 물리 Accelerator의 상세 정보를
hami.io/node-[accelerator]-registerNode Annotation에 기록한다.
kubelet의 Device Plugin 규격은 Device의 ID와 Health 상태 같은 제한된 정보만 전달할 수 있기 때문에, Accelerator의 Memory 크기 같은 상세 정보는 Device Plugin 규격으로는 전달할 수 없다. 즉 Node의 Allocatable에는 Accelerator 개수만 등록되고, Accelerator의 Memory 크기와 Core 사용률은 등록되지 않는다. 따라서 HAMi Device Plugin은 상세 정보를 hami.io/node-[accelerator]-register Node Annotation에 별도로 기록하며, 이후 Scheduler Extender가 이 Annotation을 참조하여 Scheduling을 수행한다. Annotation은 주기적으로 갱신되기 때문에 Node의 Accelerator 상태 변화도 Scheduler Extender에 반영된다.
| |
[File 1]은 Accelerator 등록 과정에서 HAMi Device Plugin이 Node에 기록하는 hami.io/node-[accelerator]-register 계열 Annotation의 예시를 나타내고 있다. 하나의 Annotation에 Node의 물리 Accelerator 목록이 담기며, Accelerator Suffix는 Accelerator 종류에 따라 바뀐다. 값은 대부분 JSON 배열로 기록되지만 일부 Accelerator는 쉼표로 구분된 문자열을 이용한다. 물리 Accelerator별로 기록되는 항목은 [Table 4]와 같다.
| 항목 | 의미 | 예시 값 |
|---|---|---|
id | 물리 Accelerator의 고유 ID (UUID 등) | "GPU-3b71a9c4-..." : Driver가 부여한 GPU UUID |
index | Node 안에서의 Accelerator 번호 | 0 : Node의 첫 번째 GPU, 1 : Node의 두 번째 GPU |
count | 물리 Accelerator 하나를 나눠 쓸 수 있는 최대 개수 | 2 : 최대 2개의 Container가 나눠 사용 가능 |
devmem | 할당 가능한 Memory 크기 (MiB) | 81920 : 80GiB의 Memory 할당 가능 |
devcore | 할당 가능한 Core 양 | 100 : Core 사용률 100%까지 할당 가능 |
type | Accelerator 모델 | "NVIDIA A100-SXM4-80GB" : GPU 모델 이름 |
numa | Accelerator가 연결된 NUMA Node | 1 : NUMA Node 1에 연결 |
mode | Accelerator의 동작 Mode | "hami-core" : 격리 Library로 공유, "mig" : MIG Instance로 분할, "enpu" : Ascend NPU의 eNPU로 분할 |
health | Accelerator의 Health 상태 | true : 정상 상태 |
[Table 4]의 항목 이름은 HAMi Device Plugin들이 HAMi의 공통 구조를 이용하기 때문에 모든 Accelerator에서 동일하지만, 값을 채우는 방식은 Accelerator마다 다르다. 예를 들어 devcore에는 Core 사용률 (%) 을 기록하는 Accelerator와 실제 Core 개수를 기록하는 Accelerator가 있으며, numa와 mode는 일부 Accelerator에서만 의미 있는 값이 기록된다. JSON 형식에서는 값이 0이거나 비어 있는 항목은 생략된다.
제조사 Device Plugin을 이용하는 Accelerator ([Table 3]) 는 Accelerator 등록을 각 제조사 Device Plugin에 위임하며, HAMi Scheduler는 제조사 Device Plugin이 등록한 정보를 참조한다.
1.2. HAMi Scheduler 지정
Accelerator를 요청하는 Pod는 Accelerator별 할당 내역을 관리하는 HAMi Scheduler가 Scheduling해야 한다. HAMi는 사용자가 Pod마다 schedulerName을 직접 지정하지 않아도 되도록, HAMi Scheduler의 Mutating Webhook이 Pod 생성 요청을 가로채서 Pod의 Scheduler를 HAMi Scheduler로 변경한다.
$ kubectl get mutatingwebhookconfigurations
NAME                                   WEBHOOKS   AGE
hami-webhook                           1          24d
monitoring-kube-prometheus-admission   1          23d

$ kubectl get mutatingwebhookconfigurations hami-webhook -o yaml
...
webhooks:
- name: vgpu.hami.io
  clientConfig:
    service:
      name: hami-scheduler
      namespace: kube-system
      path: /webhook
      port: 443
  rules:
  - apiGroups: [""]
    apiVersions: [v1]
    operations: [CREATE, UPDATE]
    resources: [pods]
  namespaceSelector:
    matchExpressions:
    - key: hami.io/webhook
      operator: NotIn
      values: [ignore]
  objectSelector:
    matchExpressions:
    - key: hami.io/webhook
      operator: NotIn
      values: [ignore]
  failurePolicy: Ignore
  sideEffects: None

$ kubectl -n kube-system get svc hami-scheduler
NAME             TYPE        CLUSTER-IP     EXTERNAL-IP   PORT(S)             AGE
hami-scheduler   ClusterIP   10.97.57.101   <none>        443/TCP,31993/TCP   24d

$ kubectl -n kube-system get endpoints hami-scheduler
NAME             ENDPOINTS                           AGE
hami-scheduler   10.244.0.24:9443,10.244.0.24:9395   24d

$ kubectl -n kube-system get pods -l app.kubernetes.io/component=hami-scheduler -o wide
NAME                              READY   STATUS    RESTARTS   AGE     IP            NODE
hami-scheduler-6d94b4bd6f-dsbg6   2/2     Running   0          3m40s   10.244.0.24   gpu
[Shell 2]는 [Figure 1]의 Mutating Webhook 경로에 이용되는 Mutating Webhook Configuration (hami-webhook) 과 Webhook 요청을 수신하는 hami-scheduler Service를 나타내고 있다. rules에 따라서 Pod 생성 요청 (CREATE) 이 Webhook을 거치며, clientConfig.service가 가리키는 hami-scheduler Service의 /webhook 경로 (443 Port) 로 요청이 전달된다.
Service의 443 Port는 hami-scheduler Pod의 9443 Port로 연결되며, 이 Pod 안의 Scheduler Extender Container (vgpu-scheduler-extender) 가 Webhook 요청을 수신한다. Endpoint (10.244.0.24:9443) 도 hami-scheduler-6d94b4bd6f-dsbg6 Pod의 IP와 일치한다. 함께 보이는 9395 Port는 [Figure 1]의 Metrics 경로와 같이 Service의 31993 Port를 통해서 HAMi Scheduler가 Prometheus Metric을 제공하는 Port이다.
Webhook은 Pod 생성 요청에서 Pod가 hami-scheduler-device ConfigMap에 등록된 Accelerator Resource ([Table 2], [Table 3] 등) 중 하나라도 요청하는지 검사하고, 요청하는 경우에만 Pod의 schedulerName을 hami-scheduler로 변경한다. schedulerName이 default-scheduler인 Pod (schedulerName을 지정하지 않은 경우 포함) 만 변경 대상이며, 다른 Scheduler가 지정된 Pod는 그대로 둔다.
1.3. Accelerator Scheduling
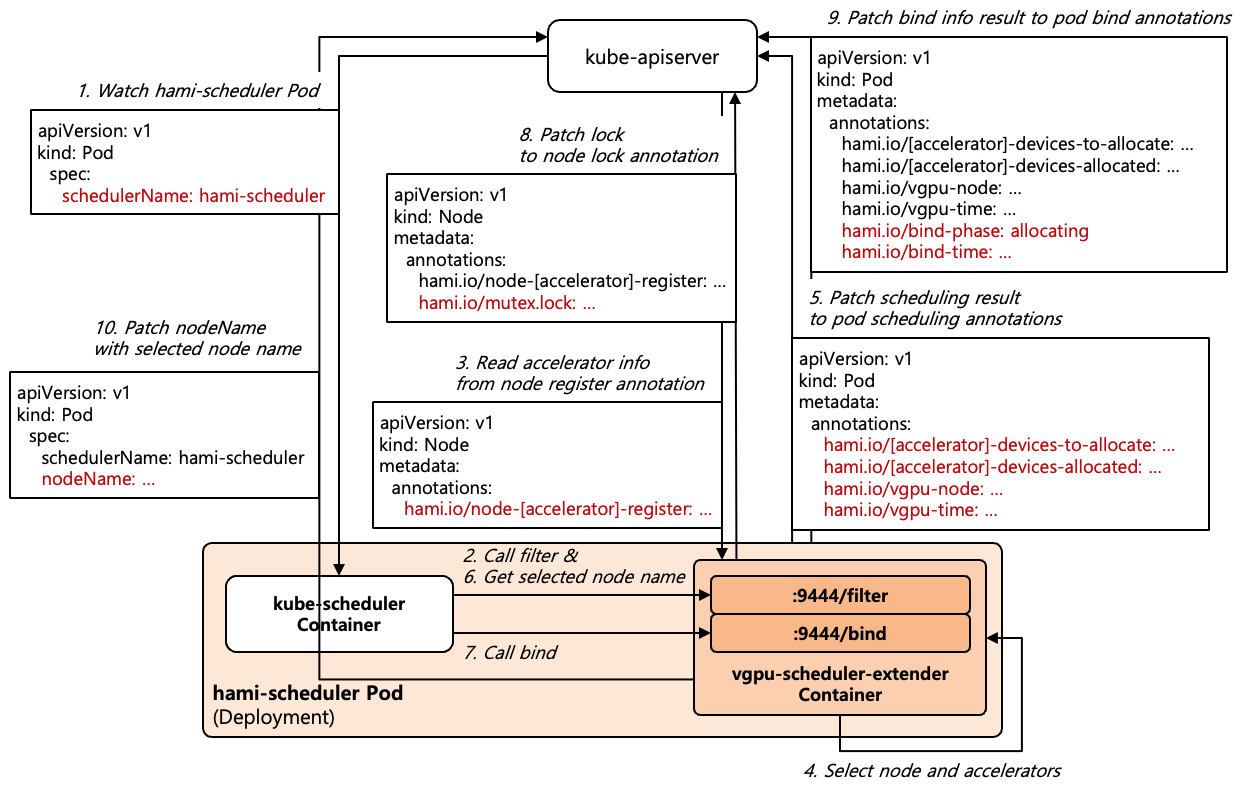
[Figure 3] Accelerator Scheduling Process
[Figure 3]은 Accelerator Scheduling 과정을 나타내고 있으며, [Figure 1]의 Scheduler Extender 경로에 해당한다.
- HAMi Scheduler 내부의 kube-scheduler는 kube-apiserver를 Watch하여
schedulerName이hami-scheduler인 Pod를 Scheduling 대상으로 가져온다. - kube-scheduler는 Filter 단계에서 Scheduler Extender의
/filterEndpoint를 호출한다. - Scheduler Extender는 각 Node의
hami.io/node-[accelerator]-registerAnnotation에 기록된 Accelerator 정보를 조회한다. - Scheduler Extender는 조회한 Accelerator 정보와 기존 할당 내역을 기반으로 요청 조건을 만족하는 Accelerator가 존재하는 Node를 선별하고, Scheduling 정책에 따라 점수를 계산하여 가장 높은 점수의 Node와 Accelerator를 선택한다.
- Scheduler Extender는 선택 결과를 Pod Annotation에 기록한다. 선택된 Accelerator의 UUID와 Memory 크기, Core 사용률 제한 값은
hami.io/[accelerator]-devices-to-allocate와hami.io/[accelerator]-devices-allocatedAnnotation에, 선택된 Node 이름과 선택 시각은hami.io/vgpu-node와hami.io/vgpu-timeAnnotation에 기록된다. - Scheduler Extender는
/filter응답으로 선택된 Node 하나만 kube-scheduler에 반환한다. - kube-scheduler는 Bind 단계에서 선택된 Node 이름과 함께 Scheduler Extender의
/bindEndpoint를 호출하며, Scheduler Extender는 전달받은 Node가 Filter 단계에서 선택한 Node와 같은지 확인한다. - Scheduler Extender는
hami.io/mutex.lockNode Annotation에 해당 Pod를 기록하여 Node를 Lock한다. Lock은 HAMi Device Plugin이 해당 Pod의 Accelerator 할당을 완료할 때까지 유지되어, 같은 Node에서 다른 Pod의 할당이 동시에 진행되지 않도록 한다. 다른 Pod의 Lock이 이미 걸려 있으면 Bind는 실패하며, Pod는 kube-scheduler에 의해서 다시 Scheduling Queue에 들어가 이후에 다시 Scheduling된다. - Scheduler Extender는 Pod의
hami.io/bind-phaseAnnotation을allocating으로,hami.io/bind-timeAnnotation을 Bind 시각으로 기록한다. - Scheduler Extender는 kube-apiserver의 Binding API를 호출하여 Pod의
spec.nodeName에 선택된 Node 이름을 설정한다.
| |
| |
[File 2]는 Accelerator Scheduling 과정에서 Scheduler Extender가 Pod에 기록하는 HAMi Annotation을, [File 3]은 Bind 단계에서 Node에 기록하는 hami.io/mutex.lock Node Annotation의 예시를 나타내고 있다. Pod Annotation의 [accelerator] 부분은 Accelerator별로 달라지며 (예: NVIDIA GPU는 vgpu, AMD GPU는 amd), [File 2]는 [Figure 1]의 Pod A처럼 Accelerator 2개를 Memory와 Core 사용률 80%로 할당받도록 Scheduling이 완료되고, 아직 Accelerator 할당은 진행되지 않은 상태를 나타낸다. Lock Annotation에는 Lock 시각, Lock을 건 Pod의 Namespace, Pod 이름이 쉼표로 구분되어 기록된다. 각 Annotation의 의미는 다음과 같다.
hami.io/[accelerator]-devices-to-allocate: 아직 Container에 할당되지 않은 Accelerator 목록. Scheduling 직후에는hami.io/[accelerator]-devices-allocated와 같은 값이 기록되며, HAMi Device Plugin이 Container에 할당할 때마다 할당을 마친 항목을 지워서 Accelerator 할당 과정이 완료되면 비워진다.hami.io/[accelerator]-devices-allocated: Scheduler가 최종 선택한 Accelerator 할당 결과. Container별로 할당된 Accelerator 정보가 기록되며, Accelerator 하나의 정보는UUID,Type,Memory,Core형식이며, Type은 HAMi가 Accelerator 종류를 구분하는 이름 (예: NVIDIA GPU는NVIDIA, AMD GPU는AMD), Memory는 MiB 단위의 크기, Core는 % 단위의 사용률이다. 같은 Container에 할당된 Accelerator 정보는:로 이어지고, 각 Container의 끝은;로 구분된다. Container 이름은 기록되지 않으며, 각;구간은 Pod spec의 Container 순서 (Init Container 먼저, 이후 일반 Container) 와 대응한다. [File 2]는 하나의 Container에 Accelerator 2개가 할당된 경우이다.hami.io/vgpu-node: Accelerator가 할당된 Node 이름.hami.io/vgpu-time: Scheduler Extender가 Node와 Accelerator를 선택한 시각 (Unix Epoch Time, 초 단위).hami.io/bind-phase: 할당 진행 상태 (allocating,success,failed).hami.io/bind-time: Bind 수행 시각 (Unix Epoch Time, 초 단위).hami.io/mutex.lock: Node의 Lock 상태. 값은LockTime,Namespace,Pod형식이며, LockTime은 Scheduler Extender가 Bind 단계에서 Lock을 건 시각을 나노초 단위의 RFC3339 형식으로 기록한 값이고, Namespace와 Pod는 Lock을 건 Pod를 나타낸다. Annotation이 존재하는 동안 다른 Pod는 같은 Node에 Bind될 수 없으며, HAMi Device Plugin은 이 Namespace와 Pod 이름으로 할당 대상 Pod를 찾는다. Accelerator 할당이 완료되면 Annotation은 Node에서 삭제된다.
$ kubectl -n kube-system get configmap hami-scheduler -o jsonpath='{.data.config\.yaml}'
apiVersion: kubescheduler.config.k8s.io/v1
kind: KubeSchedulerConfiguration
leaderElection:
  leaderElect: true
  resourceName: "hami-scheduler"
  resourceNamespace: "kube-system"
profiles:
- schedulerName: hami-scheduler           # Schedules only Pods with schedulerName: hami-scheduler
extenders:
- urlPrefix: "https://127.0.0.1:9444"     # Scheduler Extender endpoint (loopback only)
  enableHTTPS: true
  tlsConfig:
    insecure: true
  filterVerb: filter                      # Calls /filter in the Filter phase
  bindVerb: bind                          # Calls /bind in the Bind phase
  nodeCacheCapable: true
  weight: 1
  httpTimeout: 30s
  managedResources:                       # Accelerator Resources handled by the Extender
  - ignoredByScheduler: true              # Not counted by NodeResourcesFit
    name: nvidia.com/gpu
  - ignoredByScheduler: true
    name: nvidia.com/gpumem
  - ignoredByScheduler: true
    name: nvidia.com/gpucores
  - ignoredByScheduler: true
    name: nvidia.com/gpumem-percentage
  - ignoredByScheduler: true
    name: nvidia.com/priority
  - ignoredByScheduler: true
    name: cambricon.com/vmlu
  - ignoredByScheduler: true
    name: hygon.com/hcunum
  ...
[Shell 3]은 hami-scheduler ConfigMap에 저장된 KubeSchedulerConfiguration을 나타내고 있다. profiles[0].schedulerName: hami-scheduler는 HAMi Scheduler 내부의 kube-scheduler가 schedulerName이 hami-scheduler인 Pod만 Scheduling하도록 지정하며, Mutating Webhook이 Pod의 schedulerName을 변경하는 값도 바로 이 이름이다. extenders에는 Scheduler Extender가 등록된다. urlPrefix: https://127.0.0.1:9444는 Scheduler Extender의 접점이며, kube-scheduler와 Extender가 같은 Pod 안의 Sidecar Container로 동작하기 때문에 Loopback으로 호출된다. Extender의 /filter, /bind 경로는 호출자를 인증하지 않기 때문에, Service로 공개되는 Webhook Port (9443) 와 분리된 Loopback 전용 Port (9444) 에서만 제공된다.
filterVerb와 bindVerb는 Scheduler Framework의 Filter와 Bind 단계에서 Extender를 호출하도록 지정한다. kube-scheduler의 Extender 설정에는 Node 점수 계산을 맡기는 prioritizeVerb와 Preemption 판단을 맡기는 preemptVerb도 있지만 HAMi는 이용하지 않는다. prioritizeVerb가 필요 없는 이유는 Scheduler Extender가 Filter 단계에서 이미 Scheduling 정책에 따라 점수를 계산하여 가장 적합한 Node 하나만 남기기 때문이다. preemptVerb가 설정되지 않았기 때문에 kube-scheduler의 Preemption은 Scheduler Extender의 판단 없이 수행된다.
managedResources에는 Scheduler Extender가 관리하는 Accelerator Resource가 등록된다. kube-scheduler는 기본적으로 NodeResourcesFit Filter Plugin에서 Pod가 요청한 Resource와 Node의 Allocatable을 비교하여 Resource가 부족한 Node를 걸러낸다. 그런데 Accelerator의 Memory 크기와 Core 사용률을 요청하는 Resource는 Node의 Allocatable에 등록되지 않기 때문에, kube-scheduler가 그대로 비교하면 모든 Node가 Resource 부족으로 탈락한다. 따라서 ignoredByScheduler: true로 kube-scheduler가 이 Resource들을 비교하지 않도록 하고, Accelerator의 가용량 확인은 Accelerator별 할당 내역을 알고 있는 Scheduler Extender가 담당한다.
1.3.1. Scheduling 정책
| |
[File 4]는 Pod 단위로 Scheduling 정책을 지정하는 Annotation을 나타내고 있다. Scheduling 정책은 Node를 선택하는 Node Scheduling 정책과 Node 안에서 Accelerator를 선택하는 Device Scheduling 정책으로 구분된다. binpack 정책은 이미 할당량이 많은 Node나 Accelerator에 몰아서 할당하여 Accelerator 조각을 최소화하는 정책이고, spread 정책은 Node나 Accelerator에 고르게 분산하여 할당하는 정책이다. 기본 정책은 Helm 설정으로 지정하며, Pod에 이 Annotation을 지정하면 해당 Pod에만 다른 정책을 적용할 수 있다. 각 Annotation의 의미는 다음과 같다.
hami.io/node-scheduler-policy: 해당 Pod의 Node Scheduling 정책.binpack또는spread를 지정하며, Helm 설정의 기본값은binpack이다.hami.io/gpu-scheduler-policy: 해당 Pod의 Device Scheduling 정책.binpack,spread등 Accelerator별로 지원하는 값을 지정하며, Helm 설정의 기본값은spread이다.
Node Scheduling 정책 binpack과 Device Scheduling 정책 spread의 기본 조합은 Workload를 가능한 적은 Node에 몰아 Node 조각화를 줄이면서, Node 안에서는 Accelerator를 고르게 사용해 개별 Accelerator에 Hot-spot이 생기지 않게 한다. v2.10.0부터는 hami.io/gpu-scheduler-policy Annotation에 쉼표로 여러 정책을 연결해 함께 적용할 수 있다.
Scheduler Extender는 각 Node와 Accelerator에 대해 Pod가 요청한 Memory와 Core가 가용량 대비 얼마나 차지하는지를 기준으로 점수를 계산한다. binpack 정책은 할당 후 사용률이 높아지는 쪽에 가산점을 주어 Workload를 몰고 사용 중인 Node나 Accelerator 수를 줄이는 반면, spread 정책은 반대로 사용률이 낮게 유지되는 쪽에 가산점을 주어 Workload를 분산한다.
1.4. Accelerator 할당
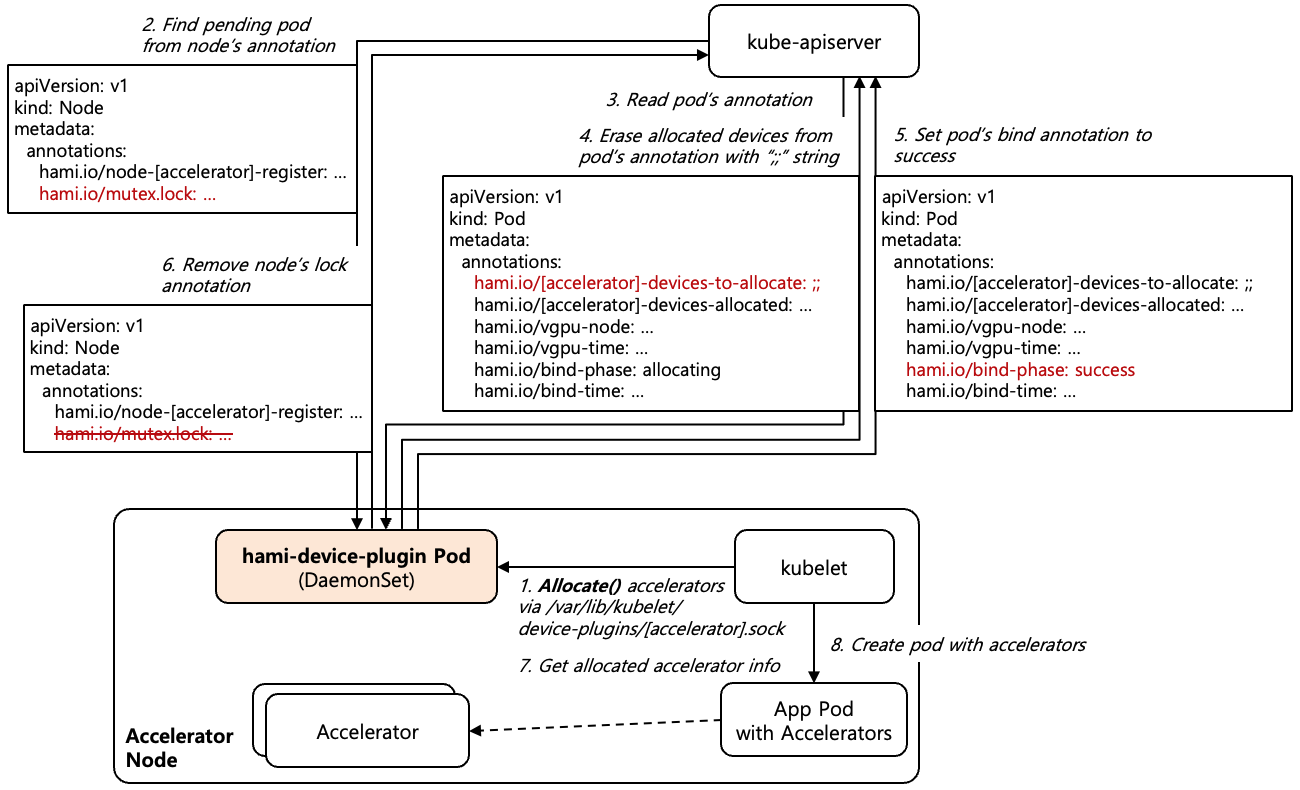
[Figure 4] Accelerator Allocation Process
Accelerator 할당도 HAMi Device Plugin이 수행하며, HAMi Scheduler가 선택한 Accelerator를 실제로 Container에 할당한다. [Figure 4]는 Accelerator 할당 과정을 나타내고 있다.
- Pod가 Bind된 Node의 kubelet은 HAMi Device Plugin에게
Allocate()gRPC 요청을 전송한다. - HAMi Device Plugin은
hami.io/mutex.lockNode Annotation에 기록된 Pod를 할당 대상 Pod로 판단한다.Allocate()요청에는 Device ID만 포함되고 Pod 정보는 포함되지 않기 때문이다. - HAMi Device Plugin은 해당 Pod의
hami.io/[accelerator]-devices-to-allocateAnnotation을 조회하여, HAMi Scheduler가 선택한 Accelerator의 UUID와 Memory 크기, Core 사용률 제한 값을 파악한다. 일반적인 Device Plugin은Allocate()요청에 포함된 Device ID만으로 동작하지만, HAMi Device Plugin은 HAMi Scheduler의 Accelerator 선택 결과를 그대로 따라야 하기 때문에 Pod의 Annotation을 참조한다. - HAMi Device Plugin은 할당을 마친 Container의 항목을
hami.io/[accelerator]-devices-to-allocateAnnotation에서 지운다. 모든 항목이 지워지면 Annotation에는;;처럼 Container 구분자만 남는다. - 모든 항목이 지워지면 HAMi Device Plugin은 Pod의
hami.io/bind-phaseAnnotation을success로 변경한다. - HAMi Device Plugin은
hami.io/mutex.lockNode Annotation을 삭제하여 Node의 Lock을 해제한다. - HAMi Device Plugin은
Allocate()응답으로 할당할 Accelerator 정보와 격리 설정을 반환한다. 반환 내용은 격리 계층에 따라서 다른데, Library 수준은 격리 Library Mount와 제한값 환경 변수가, Driver/Hardware 수준은 가상화된 Accelerator Device 참조가 반환된다. - kubelet은 반환받은 설정을 Pod의 Container에 반영하여 Pod를 생성하며, 이후 Container가 Accelerator를 사용하면 격리 계층이 Memory 크기 제한과 Core 사용률 제한을 강제한다.
Library 수준 격리에서 HAMi Device Plugin은 [Figure 1]의 Copy 과정을 통해서 Node의 Host Directory에 설치된 격리 Library의 Host 경로와 Container 경로를 Allocate() 응답의 Mount 항목에 지정하며, kubelet이 이 항목을 Container Runtime에 넘겨 Container 생성 시 [Figure 1]의 Bind Mount가 이루어진다. 즉 HAMi Device Plugin은 Mount를 직접 수행하지 않고 Mount 대상만 지정한다. 반면 Accelerator Driver Library는 Accelerator마다 전달 방식이 달라서, 제조사의 Container Runtime 확장이 주입하거나 HAMi Device Plugin이 같은 Mount 항목으로 전달한다.
1.4.1. NUMA Refit
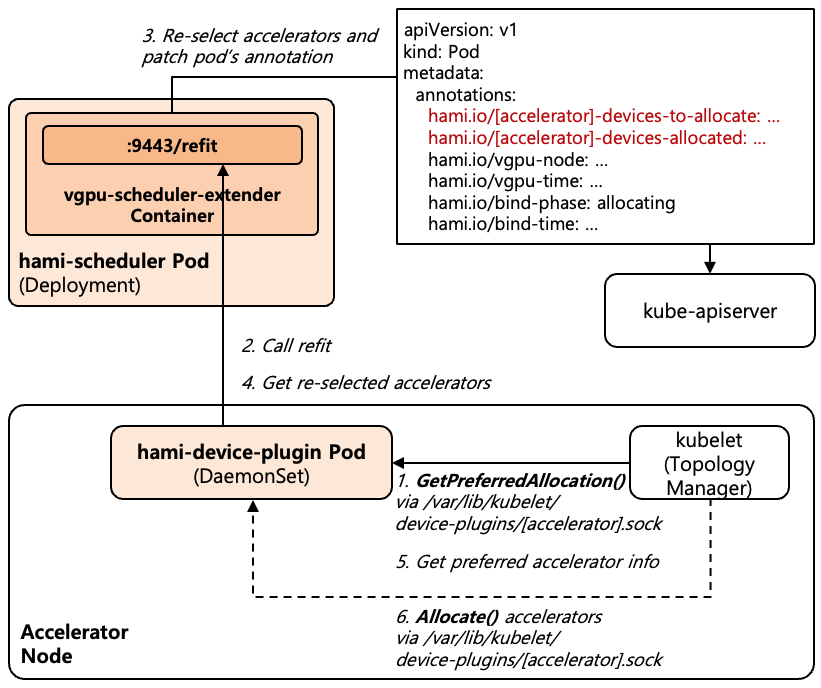
[Figure 5] NUMA Refit Process
kubelet의 Topology Manager는 single-numa-node 같은 정책이 설정되면 CPU와 Accelerator를 같은 NUMA Node에 배치하기 위해서 할당에 이용할 수 있는 Accelerator 범위를 제한한다. kubelet의 CPU Manager는 static 정책일 때 Guaranteed QoS이면서 CPU를 정수로 요청한 Container에 특정 NUMA Node의 CPU를 전용으로 할당하는데, 이 CPU는 Pod가 Node에 Bind된 이후에 kubelet이 Node의 상태를 보고 결정하며 kube-apiserver에 공개되지 않는다. 따라서 HAMi Scheduler는 Scheduling 시점에 Pod의 CPU가 어느 NUMA Node에 배치될지 알 수 없고, HAMi Scheduler가 Pod Annotation에 기록한 Accelerator가 Topology Manager가 허용한 범위에 없는 상황이 발생할 수 있다.
NUMA Refit은 이 경우 HAMi Device Plugin이 HAMi Scheduler에게 허용된 범위 안에서 Accelerator를 다시 선택하도록 요청하는 기능이며, HAMi 2.11.0에 추가되었고 현재 NVIDIA GPU만 지원하며 기본적으로 비활성화되어 있다. kubelet이 직접 Accelerator를 선택하지 않고 HAMi Scheduler가 다시 선택하는 이유는 Accelerator별 Memory, Core 할당 내역을 HAMi Scheduler가 관리하기 때문이며, kubelet이 임의로 선택하면 할당 내역과 실제 할당이 어긋나서 이후 Scheduling에서 과할당이 발생할 수 있다. NUMA Refit은 [Figure 4]의 1번 Allocate() 요청보다 먼저, kubelet이 할당할 Accelerator를 고르는 단계에서 수행된다. [Figure 5]는 NUMA Refit 과정을 나타내고 있다.
- kubelet은
Allocate()요청 전에 HAMi Device Plugin에게 Kubernetes Device Plugin 규격의 표준 API인GetPreferredAllocation()gRPC 요청을 전송하며, 요청에는 Topology Manager가 허용한 Accelerator 목록이 포함된다. - HAMi Device Plugin은 Pod Annotation에 기록된 Accelerator가 허용 목록에 없으면, HAMi Scheduler의
/refitEndpoint로 Pod 정보와 허용된 물리 Accelerator 목록을 전송한다. - HAMi Scheduler는 허용된 Accelerator 안에서만 Scheduling 단계와 동일한 정책으로 Accelerator를 다시 선택하고, 선택 결과를 Pod Annotation과 할당 내역에 반영한다.
- HAMi Scheduler는 다시 선택된 Accelerator를 HAMi Device Plugin에 반환한다.
- HAMi Device Plugin은 다시 선택된 Accelerator를
GetPreferredAllocation()응답으로 kubelet에 반환한다. - kubelet은 반환받은 Accelerator로 [Figure 4]의 1번과 같이
Allocate()요청을 전송하며, 이후 할당 과정은 갱신된 Pod Annotation을 기준으로 진행된다.
NUMA Refit을 이용하려면 Helm의 devicePlugin.numaRefit.enabled와 NUMA Topology 관련 설정을 활성화하고, Pod의 hami.io/numa-alignment Annotation에 best-effort 또는 strict Mode를 지정해야 한다. strict Mode에서는 Refit에 실패하면 Pod의 할당이 실패하고, best-effort Mode에서는 kubelet이 직접 Accelerator를 선택한다. /refit Endpoint는 Webhook과 같은 9443 Port에서 제공되며, /filter, /bind와 다르게 HAMi Device Plugin의 ServiceAccount Token으로 호출자를 인증한다.
1.5. Pod 검증
[Figure 1]의 Mutating Webhook 경로는 Pod 생성 (CREATE) 요청뿐만 아니라 Pod 수정 (UPDATE) 요청에도 이용된다. Mutating Webhook은 HAMi Scheduler를 지정하는 것 외에도, HAMi Scheduler의 할당 내역을 거치지 않고 Accelerator를 할당받으려는 Pod 요청을 다음과 같이 거부한다.
- 할당 Annotation 보호 : HAMi Scheduler가 기록하는 할당 Annotation (
hami.io/[accelerator]-devices-to-allocate,hami.io/[accelerator]-devices-allocated,hami.io/vgpu-node,hami.io/bind-phase,hami.io/bind-time) 이 포함된 Pod 생성 (CREATE) 요청을 거부하고, Pod 수정 (UPDATE) 요청에서는 Node 수정 권한을 가진 HAMi Component (HAMi Scheduler, HAMi Device Plugin) 의 변경만 허용한다. - Node 직접 지정 거부 : Pod 생성 (
CREATE) 요청에서 Accelerator를 요청하면서spec.nodeName이 미리 지정된 Pod를 거부한다. Scheduler를 거치지 않으면 할당 Annotation이 기록되지 않기 때문이다. - Privileged Container 거부 : Pod 생성 (
CREATE) 요청에서 Accelerator를 요청하는 Pod에 privileged Container가 포함되어 있으면 거부한다. privileged Container는 Node의 모든 Device에 접근할 수 있기 때문이다.
할당 Annotation을 보호하는 이유는 HAMi Device Plugin이 이 Annotation에 기록된 Accelerator와 제한 값을 그대로 따라서 할당하기 때문이다. 사용자가 할당 Annotation을 직접 지정할 수 있다면 HAMi Scheduler의 할당 내역에 없는 Memory와 Core를 할당받을 수 있다.
반면 Webhook 검증이 적용되지 않는 경우도 있다. [Shell 2]의 namespaceSelector와 objectSelector에 따라서 hami.io/webhook: ignore Label이 붙은 Namespace와 Pod는 Webhook 처리에서 제외되며, failurePolicy가 Ignore로 설정되어 있기 때문에 Webhook이 응답하지 않으면 Pod는 HAMi Scheduler 지정과 검증 없이 그대로 생성된다.
2. 참조
- HAMi GitHub : https://github.com/Project-HAMi/HAMi
- HAMi Docs : https://project-hami.io/docs/
- HAMi 지원 Device 목록 : https://project-hami.io/docs/userguide/device-supported
- CNCF HAMi : https://www.cncf.io/projects/hami/